

Grafana Dashboard & Alert Optimization
Optimize Grafana dashboards and alerts with Claude as your observability expert
What You Can Do
This skill positions Claude as your Grafana technical advisor. You can optimize PromQL queries for performance, design clear dashboards for incident response, create effective alert rules that minimize false positives, and troubleshoot visualization issues—all grounded in monitoring best practices and your specific metrics context.
Features
Reduce cardinality, improve performance, and simplify complex aggregations
Evaluate layout, panel arrangement, and information hierarchy for incident response
Create thresholds, routing rules, and notification templates with proper tuning guidance
Choose optimal panel types, refresh rates, and visualization styles for your data
Design dashboards that track error rates, p95/p99 latency, and service dependencies
Audit and recommend consistent naming conventions across your infrastructure
Refactor legacy dashboards into modern, maintainable layouts
Example Output
PromQL Optimization Example:
# Original (high cardinality, inefficient)
rate(http_requests_total[5m])

# Optimized (aggregated by job)
sum by (job) (rate(http_requests_total[5m]))

## Analysis
- Cardinality reduced from 5,000 to 50 series
- Query execution: 200ms → 40ms
- Recommended refresh: 30s (suitable for this aggregation level)
Dashboard Design Feedback:
✓ Panel grouping: API metrics, DB metrics, cache metrics — logical separation
✓ Refresh rate: 30s appropriate for incident response
✗ P95 latency title: Change from 'p95' to 'API Latency (p95)' for clarity
⚠ Alert rules: Currently trigger on static threshold — recommend adding rate-of-change rule to catch sudden spikes
Alert Rule Recommendation:
alert: HighErrorRate
expr: |
  (sum(rate(errors_total[5m])) / sum(rate(requests_total[5m])))
  > 0.05  # 5% error threshold
for: 5m  # Prevent flapping from transient spikes
annotations:
  summary: "Error rate > 5% for {{ $labels.service }}"
  runbook: "https://wiki.internal/incident/high-error-rate"
What's Included
- SKILL.md: Complete Grafana optimization framework with decision trees and troubleshooting workflows
- PromQL optimization checklist: Common anti-patterns and refactoring strategies
- Dashboard layout template: Best-practice structure (status row, trending metrics, details)
- Alert configuration guide: Threshold tuning, routing rules, notification templates
- Metric naming conventions: Standards for consistent naming across teams
- Query performance audit worksheet: Systematic review process for existing dashboards
Who It's For
- DevOps engineers designing and maintaining observability infrastructure at scale
- SRE teams optimizing alert accuracy and reducing mean-time-to-detection
- Platform engineers building internal monitoring for development teams
- Systems administrators managing shared Grafana instances across organizations
- Performance engineers tuning dashboards and metrics for application observability
Best For
- Reducing query execution time and dashboard panel load performance
- Designing dashboards that support fast incident triage and response
- Creating alert rules that catch real issues while minimizing false positives
- Optimizing PromQL for efficient metric aggregation and cardinality management
- Refactoring and migrating legacy dashboards to modern, maintainable standards
You might also like
You can leverage Claude as a structured thinking partner to organize complex multi-layered deposit sequences, identify stratigraphic anomalies, build robust site phasing models, and generate defensible interpretive narratives. Claude processes your detailed context descriptions, deposit documentation, and relationship matrices to identify patterns, flag inconsistencies, and suggest alternative interpretations you might have overlooked during field analysis.
You can transform a scheduled expert interview into a strategic session by mapping your source's public record, incentives, and known positions, then building a tiered question architecture that moves from foundational to provocative with built-in pivots. Claude helps you anticipate likely evasions, scripts pre-emptive follow-ups, flags attribution constraints, and designs your interview flow for narrative payoff—not just information collection.

Create production-ready Grafana dashboards that visualize your metrics effectively and perform efficiently. Claude helps you write optimized PromQL and other database queries, configure smart alerts with custom thresholds, and design intuitive layouts that surface the metrics that matter most. You get dashboard JSON, query recommendations, and alert configurations ready to deploy.
 by manwithstyle

You'll use structured workflows to triage production incidents in your Kubernetes cluster, gather forensic evidence from logs and metrics, and systematically identify root causes. The skill provides command templates for common failure modes—pod crashes, node failures, network issues—and generates incident timelines and remediation recommendations that you can act on immediately.

Rapidly analyze Sentry crash data to identify error patterns, extract root causes, and generate actionable incident response strategies. You'll transform raw error logs into structured incident assessments with severity levels, affected users, recovery recommendations, and team communication templates—turning firefighting into systematic problem-solving.
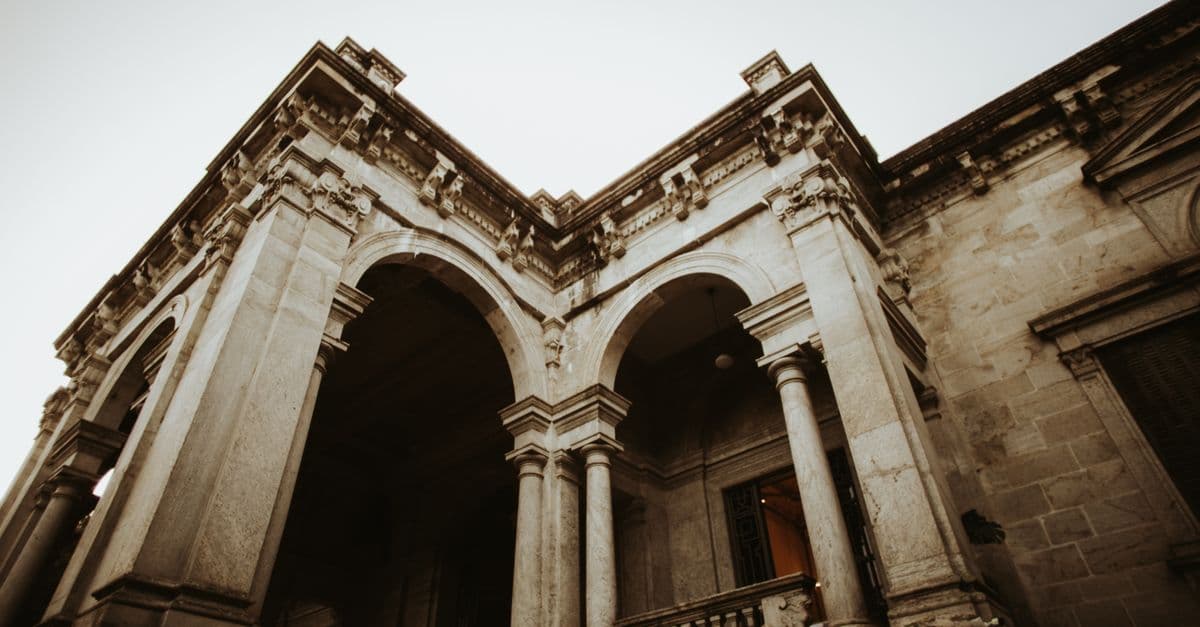
You can generate complete technical documentation packages for historic structures that meet professional preservation standards and regulatory requirements. This skill produces defensible, archival-quality records including condition assessments, measured drawing descriptions, photographic documentation protocols, material analysis frameworks, and standardized compliance reports. Your documentation serves multiple purposes—regulatory filings, restoration guidance, insurance claims, grant applications, and long-term institutional stewardship.
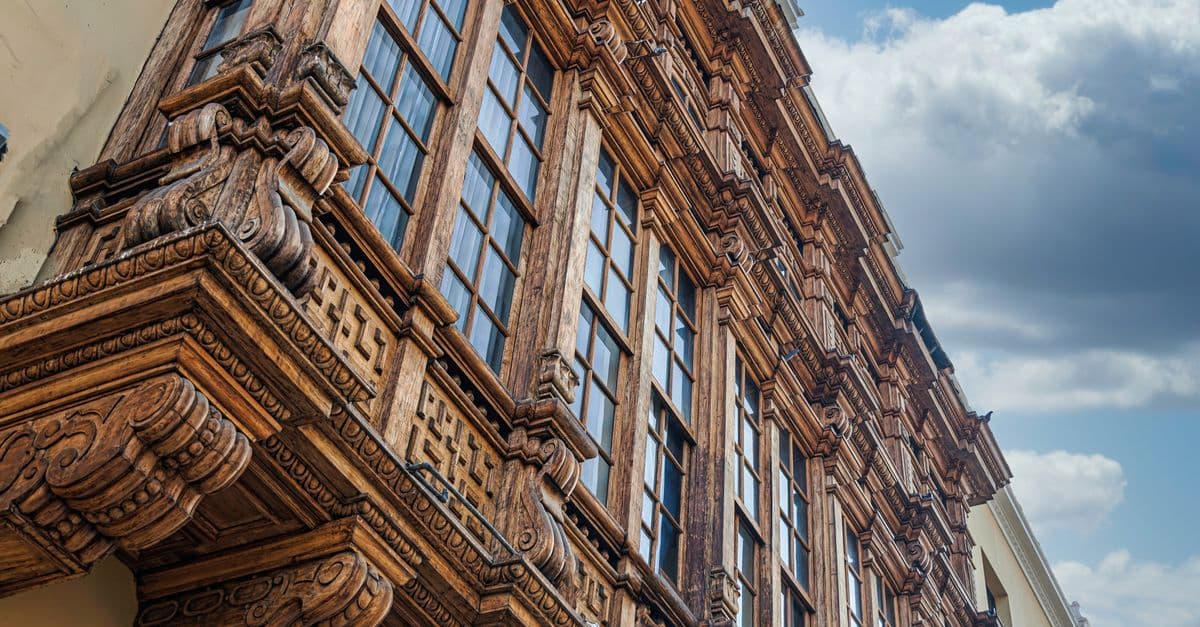
You can conduct comprehensive adaptive reuse feasibility evaluations across five critical dimensions: building assessment, regulatory environment, preservation requirements, financial modeling, and market demand. Claude helps you identify preservation constraints, map code compliance pathways, estimate cost implications, and communicate technical findings to non-preservation stakeholders—enabling you to determine project viability before committing to expensive design development and articulate clear recommendations with supporting evidence.

You can conduct comprehensive material condition assessments that capture degradation patterns, environmental factors, and damage mechanisms in historic buildings. This skill guides you through structured evaluation protocols that transform subjective observations into defensible conservation decisions, enabling you to prioritize repairs across multiple elements, justify preservation budgets to stakeholders, and specify appropriate materials and methods for contractors.